Claude Opus 5.5: Anthropic senkt Preise und verspricht effizienteres Coding
Anthropic hat Claude Opus 5.5 vorgestellt. Das Modell soll komplexe Aufgaben mit weniger Aufwand lösen. Die beworbene Kostenersparnis ist allerdings nicht mit dem Rabatt auf einzelne Tokens gleichzusetzen.
Ein neues Modell für anspruchsvolle Aufgaben
Anthropic hat am 22. September Claude Opus 5.5 angekündigt. Der Anbieter positioniert es für Programmierung und Wissensarbeit und beschreibt die Leistung bei vielen Aufgaben als vergleichbar mit Claude Fable 5.1. Die veröffentlichten Vergleiche stammen überwiegend aus Herstellerprüfungen und frühen Kundentests.
Im Mittelpunkt steht die Effizienz: Das Modell soll umfangreiche Aufgaben mit weniger Rechenschritten und geringerem Tokenverbrauch bewältigen. Für Unternehmen ist diese Kombination relevant, weil bei längeren Agentenabläufen nicht nur die Qualität einer einzelnen Antwort zählt.
Was die neuen Preise tatsächlich bedeuten
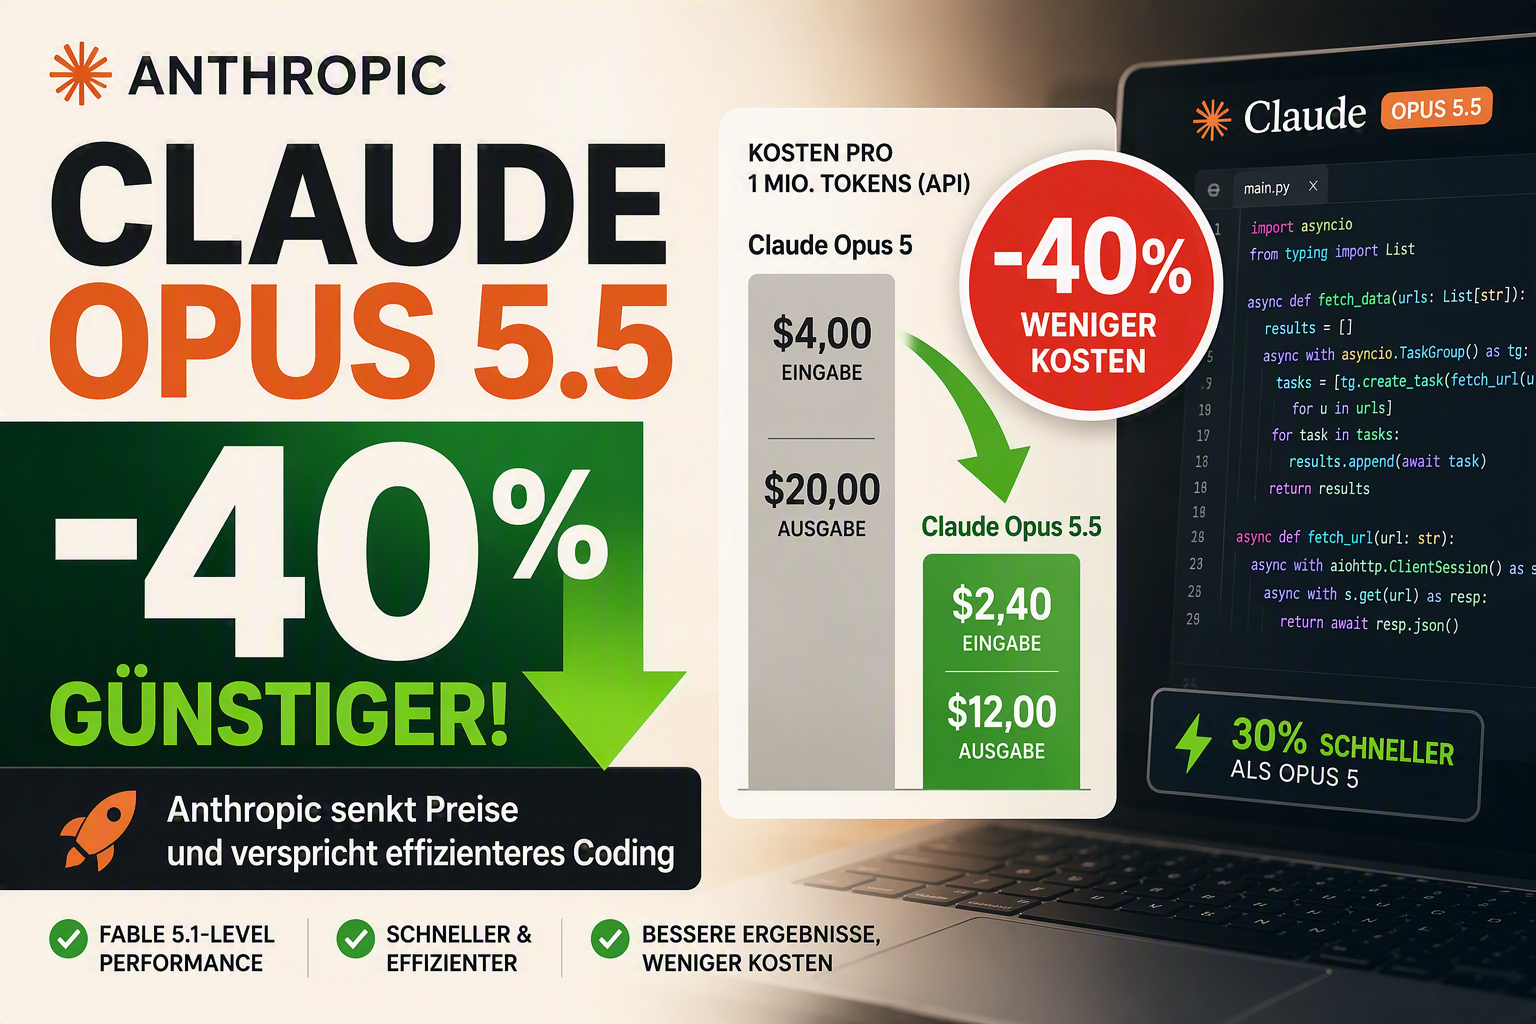
Die Standardpreise betragen laut Ankündigung vier US-Dollar je Million Eingabe-Tokens und 20 US-Dollar je Million Ausgabe-Tokens. Das sind jeweils 20 Prozent weniger als bei Opus 5. Für das Lesen bereits zwischengespeicherter Eingaben nennt Anthropic 0,20 US-Dollar je Million Tokens.
Die zusätzlich beworbene Ersparnis von 40 Prozent bezieht sich auf typische Arbeitslasten in Anthropic-Tests. Sie berücksichtigt neben Preisen auch den Verbrauch. Eine Anwendung mit anderen Eingaben, Cache-Anteilen oder Wiederholungen kann deshalb auf eine andere Gesamtrechnung kommen.
Sicherheit bleibt eine Prüfaufgabe
Anthropic berichtet außerdem über bessere Ergebnisse bei Verhaltenstests und eine höhere Widerstandsfähigkeit gegen manipulierte Anweisungen. Daraus folgt keine Garantie für fehlerfreies oder stets autorisiertes Handeln.
Für einen eigenen Vergleich bietet sich aus redaktioneller Sicht eine Sammlung klar abgegrenzter Aufgaben an: dieselben Fehlerbehebungen, dieselben Dokumente und dieselben Abnahmekriterien. Gemessen werden sollten erfolgreiche Abschlüsse, notwendige Korrekturen und Kosten pro akzeptiertem Ergebnis. Ein kurzer Einzelprompt bildet einen mehrstündigen Arbeitsablauf kaum ab.
Was Anwender daraus mitnehmen können
Wer bereits mit KI programmiert, kann zunächst an einer Kopie eines bekannten Projekts prüfen, ob Änderungen verständlich und nachvollziehbar bleiben. Eine günstigere Antwort hilft wenig, wenn die anschließende Fehlersuche länger dauert. Umgekehrt kann ein höherer Einzelpreis wirtschaftlich sein, wenn weniger Nacharbeit entsteht. Diese Einordnung ist ein Bewertungsmaßstab, kein von Futurewire durchgeführter Leistungstest.
Kommentare